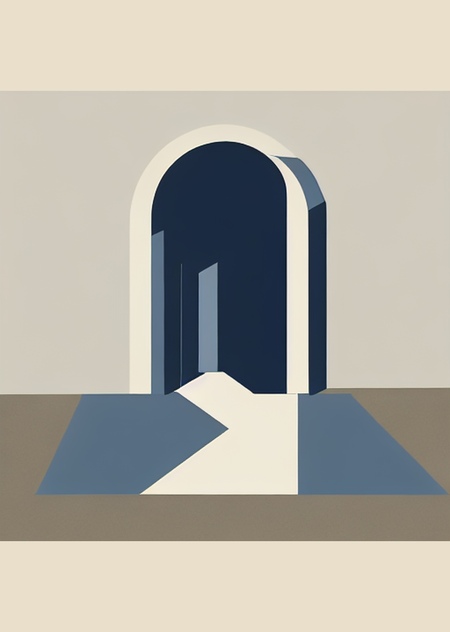
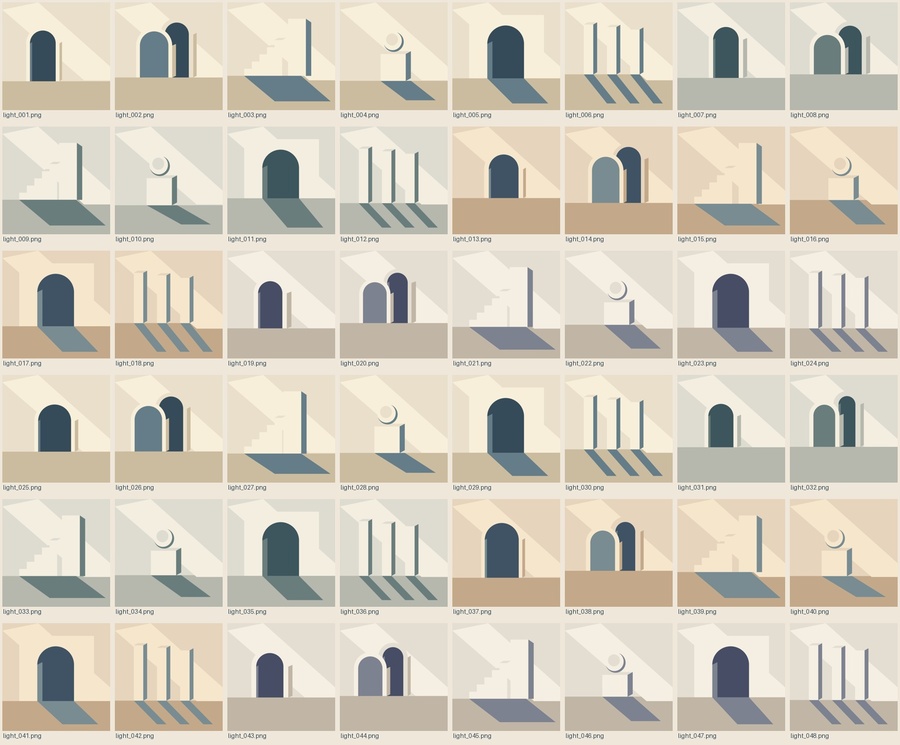
Свет сквозь формуАрхитектурные этюды о том, как свет меняет восприятие простых объёмов. Учебный эксперимент по дообучению Stable Diffusion методом LoRA.ИДЕЯВ основе проекта — отношения заполненного и пустого пространства: арки и проёма, стены и ниши, ступени и падающей тени. Простая геометрия позволяет наблюдать, как тёплые освещённые плоскости и холодные тени создают ощущение глубины.Вместо подробной архитектурной визуализации выбран язык плоского этюда: светлая штукатурка, приглушённые сине-серые тени, спокойный ракурс, отсутствие людей, декора и типографики. Задача обучения — перенести эту систему отношений на серию разных пространственных мотивов.ИСХОДНЫЙ НАБОРДля проекта подготовлены 48 оригинальных алгоритмических рисунков 512×512. Шесть мотивов: отдельно стоящая арка, две арки, лестница у стены, сфера на постаменте, арочная ниша и ритм трёх колонн. Варьируются цветовые сочетания, пропорции арок, высота горизонта и положение отдельных элементов. Каждому типу соответствует своя текстовая подпись.Рисунки выполнены программно кодом make_dataset.py, разработанным с помощью ChatGPT. Сторонние фотографии, произведения художников и материалы из чужих портфолио не использованы. Это специально подготовленные алгоритмические исходники, а не ручные рисунки или результаты дообученной модели.Такая выборка позволяет сравнивать перенос стиля между несколькими мотивами. Её ограничение — небольшой объём и сходство композиций внутри каждого типа.
ПРОЦЕСС ОБУЧЕНИЯБазовая модель — Stable Diffusion 1.5. Дообучение выполнено методом LoRA ранга 8, без отдельного обучения текстового энкодера. В каждой подписи используется маркер lghtform style и описание конкретного мотива.Обучение выполнено в Google Colab на NVIDIA T4. Параметры: 48 изображений 512×512, 400 шагов оптимизатора, batch size 1, накопление градиента 2, эффективный batch 2, learning rate 0.0001, seed 73, fp16, gradient checkpointing. Это примерно 800 предъявлений изображений с повторениями, или 16,7 прохода по набору.Журнал подтверждает завершение 400/400 шагов; финальные веса сохранены в pytorch_lora_weights.safetensors. Процесс занял около семи минут без учёта установки среды и загрузки базовой модели. Использован официальный скрипт train_text_to_image_lora.py из Diffusers версии 0.35.1.После обучения для шести сюжетов создаются пары: исходная модель и та же модель с подключённой LoRA. В каждой паре одинаковы текстовый запрос, seed, разрешение, 30 шагов DDIM и guidance scale 7.0. Такое сравнение показывает действие адаптера при фиксированных условиях.Отдельная валидационная выборка не использовалась. Ошибка обучения сама по себе не доказывает качество генерации — результат оценивается по изображениям и контрольным парам.
ИТОГОВАЯ СЕРИЯНа листе выше шесть работ расположены слева направо, сверху вниз.01. Проём и световая дорожка. Крупная светлая арка обрамляет тёмно-синий проём. Внутренние вертикали и светлая дорожка усложняют пространство. Мотив входа сохранён, но сопряжения объёмов воспринимаются как условная графика.02. Пересечение арок. Две неодинаковые арки и прямоугольный проём создают несколько уровней глубины. Диагонали связывают фон с длинными тенями. Часть границ объёмов неоднозначна.03. Лестница. Ступени читаются отчётливо; светлый марш пересекает синюю плоскость. Диагональ ведёт взгляд к верхнему проёму. Промежутки и основания требуют конструктивного уточнения: это художественный этюд.04. Диск на постаменте. Сфера из запроса превратилась в почти плоский синий диск с круглым светлым участком. Постамент и тень сохранились, шаровой объём передан слабо. Плоскостной стиль оказался сильнее описания объекта.05. Масштаб ниши. Большая голубовато-серая арка сопоставлена с маленьким светлым проёмом. Вместо глубокой ниши возникает почти самостоятельная цветная плоскость. Пустое поле усиливает ощущение тишины.06. Колонны. Светлые вертикали с тёмными боковыми гранями образуют ритм. Вместо трёх колонн модель дала больше опор — число из запроса не соблюдено. Цвет и чередование света с тенью сохраняют единство серии.
СРАВНЕНИЕ И ВЫВОДЫВ трёх парах выше слева показана базовая модель, справа — LoRA: арка, сфера и колонны. Внутри каждой пары одинаковы запрос, отрицательный запрос, seed и параметры. Генерация: 512×512, DDIM, 30 шагов, guidance scale 7, seeds 210–215. После отклонения кадра автоматическим фильтром пары 4–6 пересчитаны с уточнённым отрицательным запросом. Фильтр оставлен включённым, seeds сохранились; точные параметры — в prompts.json.У арки фотографическая фактура стены и пола заменяется плоскими цветами и крупными тенями. Базовая модель убедительнее передаёт шаровой объём, а LoRA превращает его в графический диск. Цилиндрические колонны становятся гранёными вертикалями. Перенос стиля заметен, но точная форма и количество объектов не гарантированы.Палитра и подача устойчивы. При этом набор небольшой, вариации внутри типов близки; независимая проверка на запоминание и обобщение не проводилась. Следующий этап — больше ракурсов, форм и условий освещения, индивидуальные подписи и отдельная валидация. Ручная ретушь итоговых работ не применялась; коллаж и поля обложки служат только оформлению.ОПИСАНИЕ ПРИМЕНЕНИЯ ГЕНЕРАТИВНОЙ МОДЕЛИChatGPT использован для концепции, кода алгоритмических рисунков, настройки эксперимента и текста: https://chatgpt.com/. Итоговая серия получена Stable Diffusion 1.5, реально дообученной методом LoRA: https://huggingface.co/stable-diffusion-v1-5/stable-diffusion-v1-5. Исходники и результаты представлены отдельно.КОД И МАТЕРИАЛЫВыполненный ноутбук, веса, журнал, 48 исходников, промпты и все контрольные пары: https://drive.google.com/drive/folders/1ISKDafw5iPHtwIFMF2OqI-biQcjNiun4Файлы: Свет_сквозь_форму_обучение.ipynb и Свет_сквозь_форму_полный_комплект.zip. Colab: https://colab.research.google.com/drive/1A3EofG9NrGujEhfkfKP2jhw5Vg7TJHvu. Для скачивания кода используйте также открытую общую папку.